不少人用Chatbox时token消耗飞快,额度一下子就见底,其实很多消耗都是设置不当造成的。这份实用设置教程,从记忆开关、消息上限、模型选择、对话输入到记忆压缩,整理了几个容易忽略的关键点。合理调整参数,既能减少不必要的token浪费,降低开销,还能尽量保住对话记忆,减少串台,下面跟着一步步设置即可。
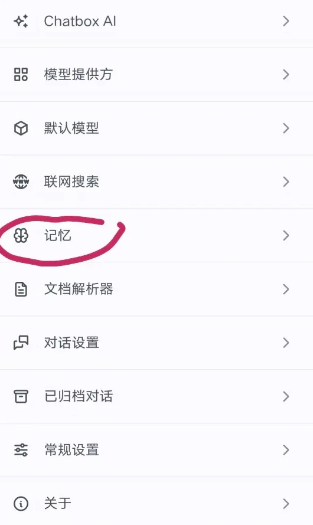
1、跨窗口记忆一定要关掉
除了费token还会和其他窗口串台,这个功能是你在A窗口说了不吃香菜,此时去新开B窗口,B窗口会自动默认你不吃香菜,关掉后不会影响已生成的前文。
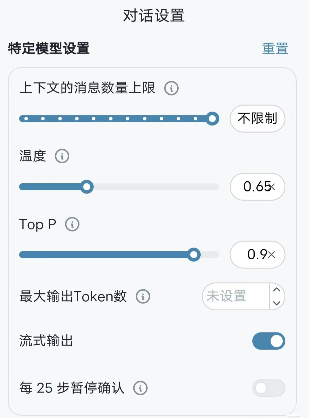
2、消息数量上限拉成不限制
这样会极大提高命中率,很多人说要开限制,但实测下来开了限制以后,每新说一句它都会把旧消息顶下去,需要从刷新的第一句重新缓存,反而开了不限制前面的都被缓存过了,不仅命中率会大大提高,还会记住很多小细节。
3、记得检查是否接错了模型
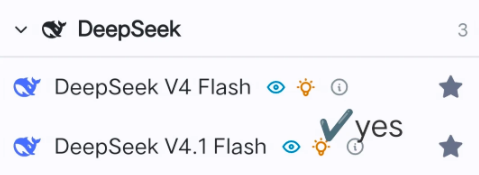
如果用的是chatbox自带的模型会特别贵,不要用chatbox ai里的deepseek,往下翻找到更多提供商,用deepseek提供的。
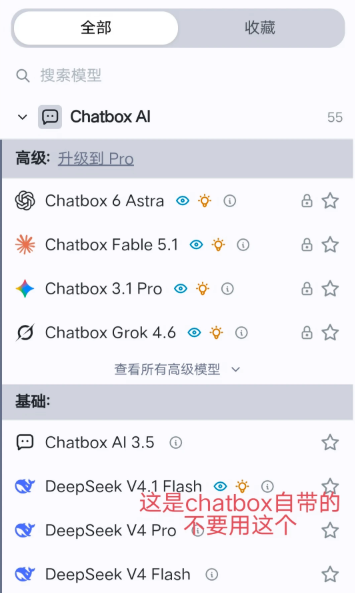
建议用deepseek v4 flash,日常文游对话用flash完全足够,如果换成pro的话,token消耗肯定比flash高出很多。
4、自己多描述一些细节
我们自己说的话(输入)比它的回答(输出)耗费低,char的发言越长耗费越高,涉及到一些无用的场景描述之类的,建议自己多说点,或者开一下对话设置里的最大输出token数。
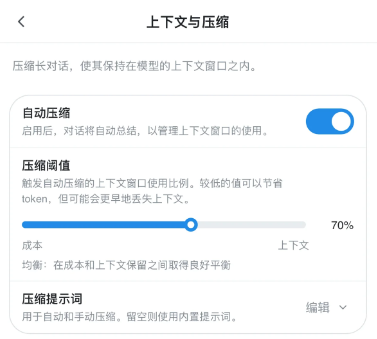
5、拉高压缩阈值
关于压缩,压缩确实会很大程度节约token,但同样会造成无法避免的细节丢失。可以在上下文文字到达50K左右的时候进行压缩对话总结一次再继续对话。
6、避开工作高峰时段
选择空闲时段进行对话,ds官网中公告显示空闲时段价格为高峰时段价格的一半。
北京时间周一至周五9:00 - 12:00、14:00 - 18:00 为高峰时段。其余时段,包括周末(周六及周日)同中国法定节假日全天均为空闲时段。
7、提高每次回合的命中率
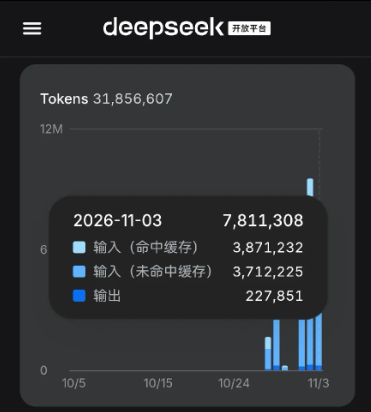
在给ai的回复中给对方写出一个大致的回答内容走向,在给ai的回复中可以注明哪一部分可以省略,不必耗费过多思路链思考。给ai发送的文字越详细,ai的命中率越高。举例子:假如用户给ai的回复是3000字左右,要ai按照这个思路回复5000字左右,命中率就会达到百分之97左右。
或者在系统提示中塞多一些详细指令,尽量避免ai对话一长后回复时需要翻找之前的聊天记录多消费的token。
攻略文章为触手软件站所有,未经允许不得转载。